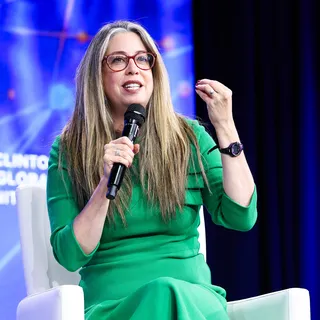
Wikimedia Vakfı'nın yeni CEO'su Bernadette Meehan, Amerikan haber sitesi Axios'a verdiği demeçte, yapay zekâ şirketlerinin Wikipedia içeriklerini izinsiz ve karşılıksız kullanmasına sert tepki gösterdi. Meehan, "Hayır kurumu değiliz, sadaka istemiyoruz" diyerek, şirketlerin bu veriler için ödeme yapması gerektiğini vurguladı. Wikipedia'nın sayfa görüntülemeleri son bir yılda %8 azaldı; bu düşüşün arkasında yapay zekâ destekli arama motorlarının ve sohbet robotlarının bilgiye erişim alışkanlıklarını değiştirmesi yatıyor.
Wikipedia'nın Karşı Karşıya Olduğu Tehdit
İnternetin en büyük ve en güvenilir bilgi kaynaklarından biri olan Wikipedia, kurulduğu günden bu yana gönüllü katkılarla ayakta duruyor. Ancak yapay zekâ teknolojilerinin yükselişi, bu modeli sarsıyor. Meehan, Axios'a yaptığı açıklamada, Wikipedia içeriğinin büyük dil modelleri (LLM'ler) tarafından eğitim verisi olarak kullanıldığını, bunun karşılığında herhangi bir telif ya da lisans ücreti ödenmediğini belirtti. "Bizden alınan verilerle milyarlarca dolarlık değer yaratılıyor, ancak bu değerden Wikipedia'nın sürdürülebilirliği için pay alınmıyor" dedi.
Wikimedia Vakfı'nın verilerine göre, 2023 yılında Wikipedia'ya yapılan bağışlar ve hibeler toplam gelirin büyük kısmını oluşturuyor. Ancak trafikteki %8'lik düşüş, önümüzdeki yıllarda bağış toplama kampanyalarını zorlaştırabilir. Zira daha az insan doğrudan Wikipedia'ya girip reklam görüyor ya da bağış çağrısına maruz kalıyor. Kullanıcılar artık bilgiye çoğunlukla ChatGPT, Google Bard (Gemini) veya Bing Chat gibi yapay zekâ asistanları üzerinden ulaşıyor. Bu asistanlar, Wikipedia'dan derledikleri bilgileri özetleyerek sunuyor ve kullanıcıyı kaynak siteye yönlendirmiyor.
Meehan, bu durumun sadece Wikipedia için değil, tüm açık bilgi ekosistemi için bir tehdit olduğunu savunuyor. "Eğer içerik üreticileri adil şekilde ödüllendirilmezse, gelecekte güvenilir bilgiye erişim ciddi zarar görür" uyarısında bulundu.
Küresel Bilgi Ekosisteminde Dengeler Değişiyor
Yapay zekâ şirketlerinin veri kullanımı, dünya genelinde hararetli bir tartışma konusu. OpenAI, Google, Meta ve Anthropic gibi devler, modellerini eğitmek için interneti tarayarak telif hakkıyla korunan içerikleri topluyor. Bazı yayıncılar ve sanatçılar bu duruma dava açarak karşılık talep ediyor. Örneğin, The New York Times, OpenAI'ye karşı açtığı davada, milyonlarca makalesinin izinsiz kullanıldığını öne sürüyor.
Wikipedia ise özgür lisans modeliyle (Creative Commons) içeriklerini sunuyor. Bu lisans, içeriğin kopyalanmasına, dağıtılmasına ve değiştirilmesine izin veriyor; ancak ticari kullanım için bazı sınırlamalar getiriyor. Yapay zekâ şirketlerinin bu lisansın ruhunu ihlal ettiği iddiası giderek güçleniyor. Meehan, Wikimedia'nın yasal yollara başvurmayı düşünebileceğini ancak öncelikli tercihinin müzakere olduğunu belirtti. "Diyalog kapımız açık. Ancak adil bir gelir paylaşımı olmadan bu iş yürümez" dedi.
Uzmanlar, Wikipedia'nın karşılaştığı sorunun tüm açık kaynak ve gönüllü bilgi projeleri için emsal teşkil ettiğini söylüyor. Eğer Wikipedia ayakta kalamazsa, yapay zekâ modellerinin eğitimi için gereken temiz ve güvenilir veri havuzu da kuruyabilir. Bu da yapay zekânın kalitesini ve güvenilirliğini olumsuz etkileyebilir.
Wikimedia Vakfı, 2023-2024 mali yılında yaklaşık 180 milyon dolar gelir elde etti. Bu gelirin büyük bölümü bireysel bağışlardan oluşuyor. Ancak trafik düşüşü devam ederse, önümüzdeki yıllarda gelirde azalma riski var. Vakıf, bu nedenle yapay zekâ şirketleriyle lisans anlaşmaları yapmayı ve içerik kullanımı için ücret talep etmeyi planlıyor.
Türkiye Açısından Değerlendirme
Wikimedia'nın yapay zekâ şirketlerinden telif talep etmesi, Türkiye'deki dijital yayıncılar ve içerik üreticileri için de emsal oluşturabilir. Türkiye'de birçok haber sitesi ve bağımsız medya kuruluşu, içeriklerinin yapay zekâ tarafından izinsiz kullanıldığından şikâyetçi. Eğer Wikimedia girişimi başarılı olursa, Türk şirketleri de benzer adımlar atabilir. Ayrıca Wikipedia'nın trafik kaybı, Türkiye'deki kullanıcıların bilgiye erişim alışkanlıklarını da etkiliyor; zira Wikipedia, Türkiye'de zaman zaman erişim engelleriyle karşılaşsa da önemli bir başvuru kaynağı olmayı sürdürüyor. Yapay zekâ modellerinin Türkçe içerik üretiminde Wikipedia'dan beslenmesi, dilin dijital geleceği açısından da kritik.